Chinese Podcasts Dataset:中文播客语音数据集,推进普通话自然语音生成技术
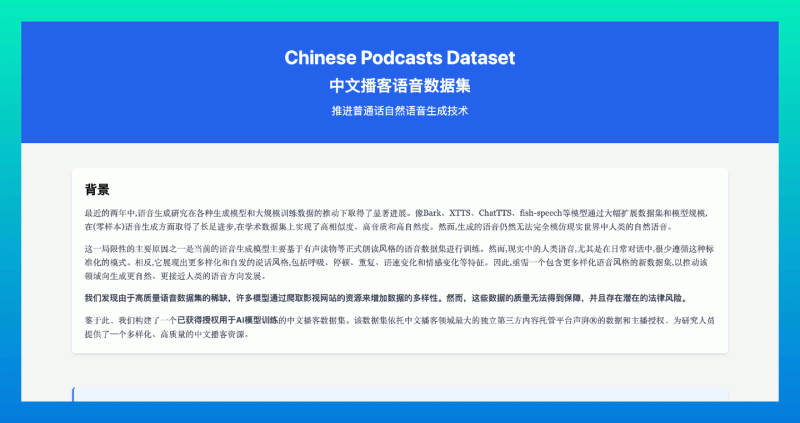
在语音生成领域,中文播客数据集凭借其丰富多样的内容和高质量的录音,正在成为推动自然语音生成技术的重要资源。
中文播客数据集是一个专为语音生成模型训练设计的高质量、合法授权的语音数据集。该数据集基于中文播客内容,涵盖了多样化的语音风格和情感表达。
一、功能特征
-
多样化数据来源:涵盖日常对话、专业讨论、故事叙述等多种场景。
-
自然语音特征:保留了真实人类语音的特征,如呼吸声、停顿、语速变化等。
-
高质量录音:采用专业设备录音,确保最小的环境干扰。
-
丰富情感表达:从平静叙述到激烈讨论,展现真实对话中的情感变化。
-
完善的标注:每个音频片段都配有准确的文本转录,便于模型训练和评估。
二、操作指南
- 访问网站并注册账号。
- 浏览数据集详情,选择适合的版本(公开评估或全量数据集)。
- 提交申请并支付费用,下载数据集。
三、支持平台
- 该数据集可在所有主要AI平台和语音生成模型中使用,支持各类编程语言和工具。
四、产品定价
-
公开评估数据集:免费提供,但需遵守数据使用协议。
-
全量数据集:需付费使用,具体费用视使用场景而定。
五、使用场景
-
AI语音合成:用于训练更自然、更贴近人类真实对话的语音合成模型。
-
语音识别:提高自动语音识别系统的准确性。
-
情感分析:研究和分析不同情感在自然语音中的表现。
六、运作模式
- 授权与分成:平台通过内容创作者授权的方式获取播客数据,并将部分收益分配给创作者。
结语
中文播客数据集为语音生成技术的发展提供了强大的数据支持。未来,它将在推动自然语音生成技术中发挥更大的作用。
网址:dataset.wav.pub